在Claude的带领下认识堆(1)
目前我的整个学习进度其实还在栈,好多栈的题目还是没有搞得很明白,也是因为pwn的太多重要的东西在堆这一块,以及在看论文的时候,堆的内容涉及的比较多,所以就过来简单了解一下,个人感觉整个Claude的思路还是相当的清晰
堆 vs 栈:最核心的区别
| 栈 (Stack) | 堆 (Heap) | |
|---|---|---|
| 管理方式 | 编译器自动分配/回收 | 程序员手动 malloc/free |
| 生命周期 | 函数返回即销毁 | 直到你 free 才释放 |
| 大小 | 小(一般 8MB),编译期基本确定 | 大,运行时动态增长 |
| 增长方向 | 向低地址增长 | 向高地址增长 |
| 速度 | 快(就移动一下 rsp) | 慢(要查找/管理空闲块) |
| 出错后果 | 栈溢出、返回地址劫持 | UAF、double free、堆溢出 |
其实要思考一下,为什么我们需要堆?
栈适合管理生命周期明确、大小通常已知的临时数据,而堆允许程序在运行过程中动态申请内存,并让数据在需要的时候继续存在
根据这点,其实我很好奇,为什么没有一个东西可以综合二者优点呢?
有如下限制:栈是严格按照顺序申请和释放内存,按照后进先出的规则(LIFO),一块挨着一块,只需管理指向内存的指针就能完成内存的分配和释放,释放了就没了,整个过程简单高效;但是堆呢,诶,放进去的内存,我任意释放,想放哪个就哪个,这就形成一个问题,释放掉的数据放在哪呢,再次申请内存时,先前释放后留下的空间可以重复利用吗,空间够大吗,去哪寻找新的内存空间,整体实现更个性化的分配与释放
这个就是在分配释放的高效、生命周期的灵活和自动安全管理之间做到平衡
我查了一下,好像已经有类似的系统出现了,感兴趣可以去了解一下,我这里就不介绍了
理解了堆的存在必要性,然后学习一下堆的结构和工作原理
Linux 上 malloc 背后是 ptmalloc2 这个分配器。核心思想:向操作系统批发大块内存,然后零售出去
堆的基本单位是chunk(块)
一个已分配的 chunk 结构如下:
+-----------------+ |
- size:这个 chunk 的大小(8 字节对齐,所以低 3 位空出来当标志位)
- P (PREV_INUSE):前一个 chunk 是否在用。这个位在利用里超级重要。
- malloc 返回的指针(叫 mem)指向数据区,但真正的 chunk 头在它前面 0x10 字节。
当free掉一个chunk的时候,它不会马上还给系统,而是被挂进一个空闲链表,叫 bin,方便下次复用。
这里列出 glibc 里的几种 bin
| Bin 类型 | 装什么 | 结构 | pwn 常客 |
|---|---|---|---|
| tcache | 小块(≤0x408),每种大小 7 个 | 单链表 (LIFO) | ⭐ 新手入门首选 |
| fastbin | 小块(≤0x80) | 单链表 (LIFO) | ⭐ 经典 |
| unsorted bin | 刚 free 的中大块 | 双链表 | ⭐ 泄漏 libc |
| small bin | 中等块 | 双链表 | |
| large bin | 大块 | 双链表 | 进阶 |
空闲 chunk 会复用数据区来存链表指针(原本存放用户数据的数据区)
+-----------------+ |
这里就存在三大经典漏洞(以后做题目会碰到):
- Heap Overflow(堆溢出):往一个 chunk 里写超界,覆盖掉下一个 chunk 的头部(size、fd 等)。
- Use-After-Free (UAF):free 之后指针没清空,还能继续读写这块已经”还回去”的内存。读→泄漏地址;写→篡改 fd。
- Double Free:同一个块 free 两次,让它在 bin 里出现两次,制造出”一块内存属于两个人”的局面。
接着我们用一个带注释的 C 小程序 + 内存图,实际看 malloc/free 时 chunk 和 bin 怎么变
pwndbg> b 23 |
程序会先打印 a/b/c 的地址,然后停在断点 1
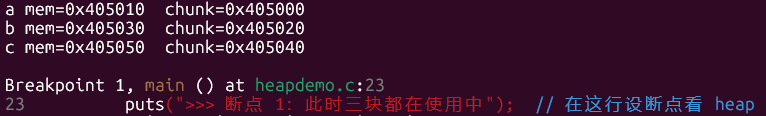
输入heap,查看堆内存的状态
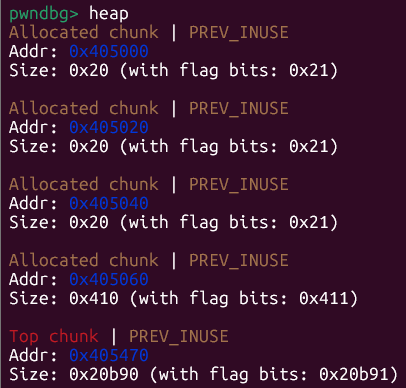
A、B、C 各占 0x20,头挨着头:0x405000 → 0x405020 → 0x405040,正好每次 +0x20
会发现一个奇怪的事:0x410是啥
这个是 stdio 缓冲区。程序里用了 printf/puts,第一次输出时 glibc 会 malloc 一个 0x400 的缓冲区来缓存 stdout——这就是它。以后会经常看到这种”不是我申请的块”,知道是 libc 自己用的就行,别当成自己的。
注意一开始的a mem=0x405010 chunk=0x405000 和 Addr: 0x405000 对应上了,说明 malloc 返回的指针(0x405010)= chunk 头(0x405000)+ 0x10,那 0x10 就是 chunk 头部(prev_size + size)
结合前面堆的图表,这么理解:malloc() 返回的地址,也就是可以写入数据的地方
输入vis,把内存布局、数据结构或执行状态直观地展示出来
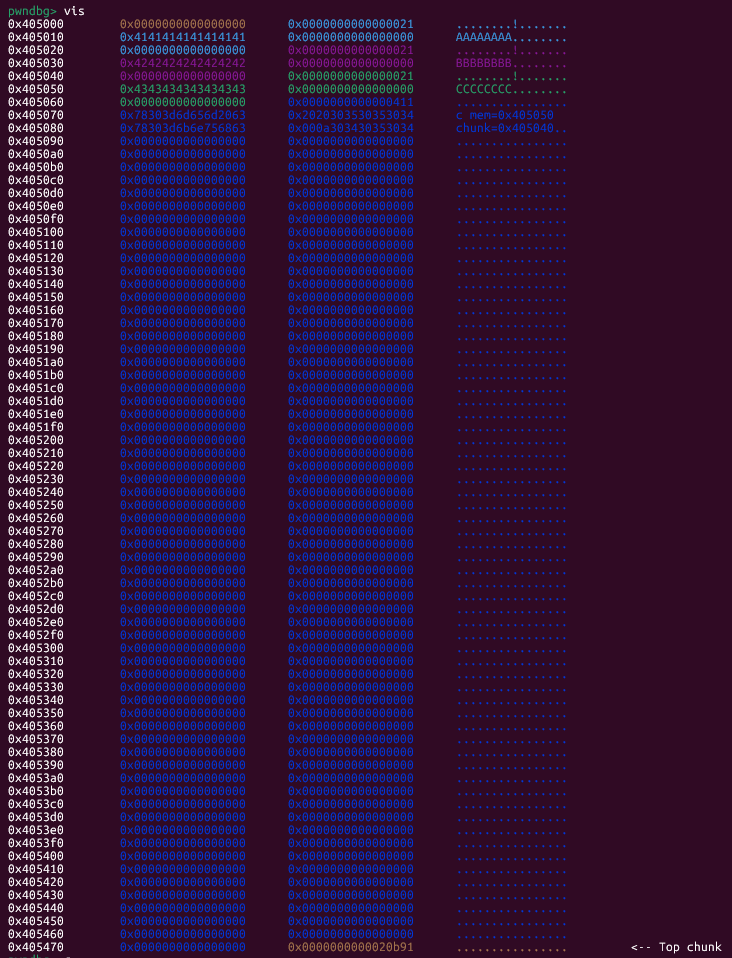
内存地址 前8字节 后8字节 ASCII ------这样理解着看 |
在 0x405010、0x405030、0x405050 那几行右边,能看到 AAAAAAAA、BBBBBBBB、CCCCCCCC 的 ASCII。确认一下数据区的位置。
输入c,继续运行程序,到下一个断点:
输入tcachebins,查看当前线程的 tcache 空闲 chunk 链表:
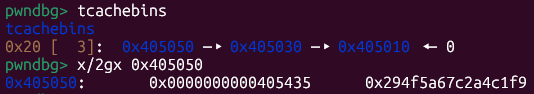
这里是核心知识
0x20 [ 3]: 0x405050 —▸ 0x405030 —▸ 0x405010 ◂— 0 |
可以得到三点:
- 顺序是反的,意味着是后进先出(LIFO),free 的顺序是 a→b→c,但链表头是 c。每次 free 都插到表头,所以最后进的 c 排第一
- 箭头指的就是每块里的 next 指针,如c(0x405050),数据区现在存的不再是 CCCCCCCC,而是指向 b 的指针 0x405030
- pwndbg 已经悄悄帮我们解密了,内存里真实存的 next 是加密过的(safe-linking)
第三点通过 x/2gx 0x405050 查看c 块里原始存的值 来验证

0x405050: 0x0000000000405435 0x294f5a67c2a4c1f9 |
公式是:加密值 = 真实next ^ (当前块地址 >> 12)
key:指向 tcache 管理结构。它的作用是检测 double free:free 一个块时,glibc 会看它的 key 是不是已经等于 tcache 结构,如果是就怀疑”这块已经在 tcache 里了”,报 double free detected
Claude注:你这个值看起来像随机数而不是堆地址,是因为新版 glibc 又给 key 加了一层随机化(防止攻击者轻易伪造/绕过 double-free 检测)。老一点的 glibc 这里会直接是 tcache 结构的地址,比如 0x405010 开头那种。无所谓,知道它是”防 double free 的标记”就够了
不禁感叹每一个随机化的防范,或许都是一场安全事故的发生,每一个网安人都是在为这些小小的漏洞默默付出
继续验证一下LIFO
输入c
d mem=0x405050 == c |
再输入tcachebins
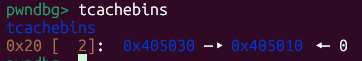
结合前面的验证
断点 2(free 完 a,b,c): 0x20 [ 3]: c(0x405050) —▸ b(0x405030) —▸ a(0x405010) ◂— 0 |
链表从 3 变 2,malloc 从链表头把 c 摘下来了,这就是 LIFO(后进先出)
综上:
| 亲眼验证的 | 底层机制 |
|---|---|
| chunk 头 = 0x10,mem = chunk + 0x10 | 每块都有 prev_size + size 头部 |
| Size 0x20 (0x21) | 低 3 位是标志位,0x21 = 0x20 | PREV_INUSE |
| free 后数据区变成 next 指针 | 空闲块复用数据区存链表 |
| 链表顺序和 free 顺序相反 | tcache 是 LIFO |
| 0x405435 异或 0x405 还原地址 | safe-linking 加密 |
| key 字段 | double-free 检测 |
未完待续~
将会在另一个文章写tcache poisoning的内容
反思:也许我这个文章放在五年前,算是一个可以的关于认识堆的文章,可以给其他新手带来点灵感,但在AI时代,没有比AI更适合的老师了
我也不知道我发展的方向会不会被AI取代;
现在越是可以通过AI触手可得,越是让我恐惧。
也许像黄仁勋说的,现在的学生要学会向AI发问。
学习不再是为了存储知识,而是懂得提出更有价值的问题。
AI也许就是这个时代的工业革命,带来机遇,也做筛选。
其实也要感谢一位学长曾指出我一开始的几篇纯AI文章,掀开了那层AI遮羞布,让我直面自己空洞的知识体系,让我下定决心自己手写blog
不要沉迷于AI的力量,不要让AI代替思考,我希望这句话可以一直警醒我